
はじめに
この記事は SRE 連載です。 前月の記事ははてなブログに Amazon CloudFront SaaS Manager を導入した話でした。
前月に引き続き  id:hagihala です。
はてなのとある Perl で実装された大規模サービス (以下「対象サービス」) は、Amazon ECS Fargate 上で運用しています。コスト最適化を検討するにあたり「Graviton (arm64) に移行すればコストが下がるのでは」という仮説のもと検討を始めたのですが、対象サービスのワークロードで実際に速くなるのか、信頼できるデータが必要でした。また昨年9月に Amazon ECS Managed Instances が登場し、「Fargate のまま行くか、ECS on EC2 にするか」の中間の選択肢も増えていました。
ECS Managed Instances は、プロビジョニングやパッチ適用などのインスタンス管理を AWS が代行してくれる、EC2 ベースの ECS コンピューティングオプションです。Fargate と違って使用するインスタンスタイプ (つまり CPU 世代) を指定でき、料金は EC2 料金に管理料 (On-Demand 料金の 12%) を上乗せした形になります。
そこで、実行基盤の選定材料とするため、ECS の各実行環境 (Fargate amd64 / arm64、ECS Managed Instances の各インスタンスファミリー) で CPU 性能とコストを実測して比較しました。
やったこと
- アプリケーションイメージに DKbench (Perl 汎用ベンチ) と
hotspot(アプリの実コードを使った自作マイクロベンチ) を組み込み、ECS タスクとして多数起動して計測する基盤を構築しました - アーキテクチャ間比較: Fargate (amd64 / arm64) と ECS Managed Instances (以下 MI) の各インスタンスファミリー (c6i / c6a / c6g / c7i / c7a / c7g / c8i / c8a / c8g、いずれも 8vCPU/16GB スロット換算) で性能・コストパフォーマンスを比較しました
- CPU 世代間比較: Intel (c6i→c8i) / AMD (c6a→c8a) / Graviton (c6g→c8g) の世代ごとの性能差と、処理内容による得意不得意を分析しました
- Fargate で割り当たる CPU 世代のばらつき (いわゆる CPU ガチャ) をタスクサイズ別に調査しました
- EC2 自前運用と MI の損益分岐点をコストモデルで算出しました
- 補足として、スケールアウト (0→50 タスク) の起動時間も Fargate / MI で比較しました
先に主要な結論をまとめると、次の4点です。
- Fargate の CPU 世代はタスクサイズによって出現傾向が大きく異なります。0.5 vCPU 以下は最旧世代 (c5 / c6g) しか出ず、amd64 は 1 vCPU でも 71% が c5 でした
- 性能は c8a > c8i > c8g の順で新世代が強く、特に c8a はアプリ実処理 (
hotspot) で baseline の 1.61 倍でした - コストパフォーマンスは指標によって逆転します。汎用ベンチ (DKbench) 基準では c8g (1.19)、アプリ実処理基準では c8a (1.38) / c8i (1.18) が最良でした。Graviton は今回の Perl アプリ実処理に弱く、アプリ基準では優位がほぼ消えます (c8g 1.05)
- 常時数十台規模を運用するなら EC2 自前運用が MI より安くなり得ます (損益分岐台数は運用工数の見積もり次第です。本文では月 $1,000 と仮置きして試算しました)
計測は 2026年6月中旬〜7月中旬に ap-northeast-1 (東京リージョン) で行いました。コストは全構成とも Compute Savings Plans (1年・全額前払) の実レート (2026-06-30 時点の価格表) で統一しています。
- はじめに
- Fargate タスクの CPU 世代の出現傾向 (CPU ガチャ)
- ベンチマーク結果
- ベンチマークの取り方の工夫・難しさ
- 補足: スケールアウト起動時間の比較
- どういうパターンでどの構成を選択すると良いか
- まとめ
- 付録
Fargate タスクの CPU 世代の出現傾向 (CPU ガチャ)
Fargate ではタスクがどの世代の CPU で動くかを利用者が制御できず、起動ごとに割り当てが変わります。俗に「CPU ガチャ」と呼ばれる現象です。どの世代に当たったかは、ECS のタスクメタデータと /proc/cpuinfo から判定できます。
今回のベンチマークはシングルコア性能の測定が目的だったため、最初は小さなタスクサイズで走らせていたのですが、念のため実運用を想定した大きなサイズでも試したところ CPU 世代の出現傾向が大きく異なることに気づきました。そのためタスクサイズ (0.25〜16 vCPU) ごとに各 100 タスクを起動し、割り当たった CPU 世代を集計してみました。
なお Fargate は 2026年6月に 32 vCPU までサポートされるようになりましたが、今回のスイープは 16 vCPU までを対象としています。
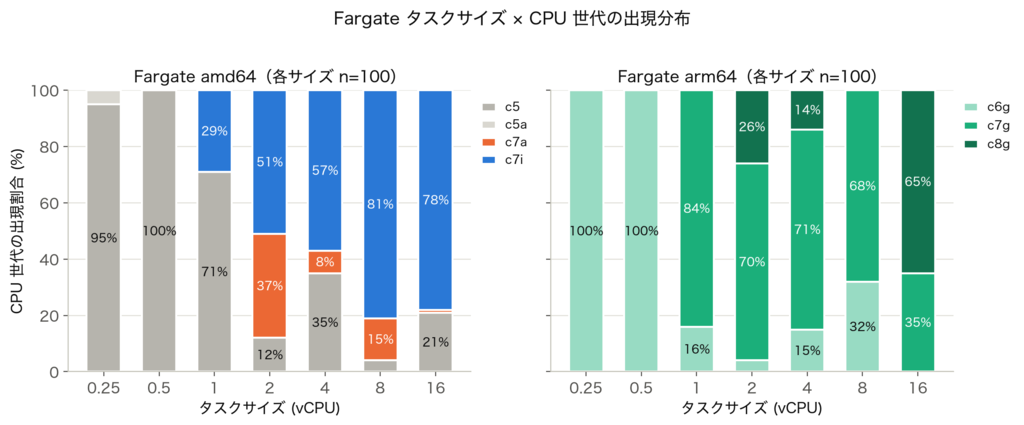
結果、タスクサイズによって CPU 世代の出現傾向が大きく異なることがわかりました。
| arch | 0.5 vCPU 以下 | 1 vCPU | 2 vCPU 以上 |
|---|---|---|---|
| amd64 | c5 世代のみ (Skylake / Cascade Lake, 95〜100%。残りも c5a) | c5 71% / c7i 29% | c7i / c7a が 65〜96%。c5 も 4〜35% 残る |
| arm64 | c6g (Graviton2) のみ 100% | c7g 84% / c6g 16% | c7g / c8g が 68〜100%。c6g は 0〜32% |
- 小さいタスクは旧世代ホストに寄せられている傾向が明確で、0.5 vCPU 以下では最旧世代しか引けませんでした
- 最新世代の出方はサイズと arch で偏ります。arm64 は計測した中で最大の 16 vCPU で c8g が 65% と、大きいサイズほど新しい世代が出やすい一方、8 vCPU では c8g が 0% でした。amd64 では c8 系 (c8i / c8a) が全サイズで一度も出ませんでした
- 同一サイズでも回によって分布は変わります。例えば 8 vCPU amd64 は、ベンチマーク本番の run では c7i 47% / c7a 36% / c5 16% でしたが、このスイープ調査では c7i 81% / c7a 15% / c5 4% でした。世代は制御できず、性能のばらつきとして現れます。曜日や時間帯などによる違いもあるかもしれませんが今回は深掘りしませんでした
- サイズ別の DKbench Overall (各 n=100) でも、2 vCPU 以上では min が mean より 15〜30% 低く、ガチャの外れ (旧世代) を引いた際の性能低下がそのまま観測されました
ベンチマーク結果
計測条件
ベンチマークには次の2つを使いました (詳細は付録参照)。
- DKbench: Perl 向けの汎用 CPU ベンチマークスイート。
Overall Avg Scoreを採用 (高いほど速い) hotspot: 対象サービスの実コードを使った自作マイクロベンチ。実際のホットスポットに対応する 11 ケースを計測 (ops/sec、高いほど速い)
計測条件は以下のとおりです。
- 全 run 共通で 8vCPU/16GB のタスクサイズ。DKbench はシングルスレッド 5 iteration、
hotspotは warmup 後に 15 回計測 - Fargate は世代のばらつき (ガチャの傾向と最悪ケース) を含んだ全体的な性能を測るため n=100、MI は世代が固定さればらつきが小さいため n=5 としました
- 正規化はすべて baseline = fargate-amd64 の mean = 1.00
- コストは全構成とも Compute Savings Plans (1年・全額前払) の実レートで比較。Savings Plans の割引率はファミリー・arch で異なるため、割引率換算ではなく価格表の実レートを使用しています
注意事項 (本ベンチマークの限界)
hotspotの集約値 (幾何平均) は各ケース等重みです。実サービスでのエンドポイント別の呼び出し回数や CPU 時間の統計に基づく重み付けはしていないため、実トラフィックでの性能差とはずれる可能性があります- Perl のシングルコア性能を測ったベンチマークです。別の処理系 (例: Go 実装)、マルチコアスケーリングが効くワークロード、I/O バウンド・メモリバウンドな処理では、各 CPU の優劣やコストパフォーマンスの結論が変わり得ます。本記事の結論は「CPU バウンドな Perl 処理」という前提の範囲で読んでください
総合結果
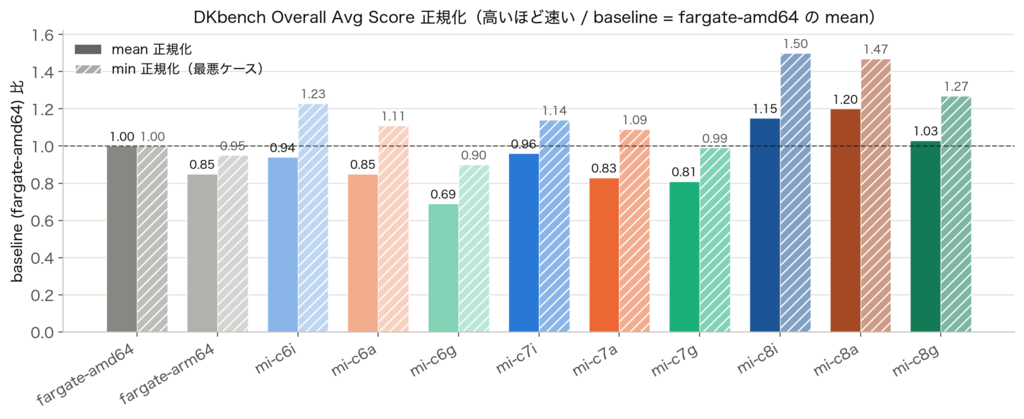
| run | n | CPU 世代 | DKbench mean | DKbench min | DK 正規化 | hotspot 正規化※1 |
実効 $/h※2 |
|---|---|---|---|---|---|---|---|
| fargate-amd64 | 100 | 混在 (c7i 47% / c7a 36% / c5 16% / c6a 1%) | 14,593 | 10,913 | 1.00 | 1.00 | 0.385 |
| fargate-arm64 | 100 | 混在 (c7g 44% / c6g 43% / c8g 13%) | 12,476 | 10,360 | 0.86 | 0.67 | 0.290 |
| mi-c6i | 5 | c6i (Ice Lake) | 13,671 | 13,426 | 0.94 | 0.84 | 0.355 |
| mi-c6a | 5 | c6a (EPYC Milan) | 12,374 | 12,070 | 0.85 | 0.87 | 0.319 |
| mi-c6g | 5 | c6g (Graviton2) | 10,064 | 9,789 | 0.69 | 0.53 | 0.305 |
| mi-c7i | 5 | c7i (Sapphire Rapids) | 13,999 | 12,460 | 0.96 | 1.05 | 0.372 |
| mi-c7a | 5 | c7a (EPYC Genoa) | 12,180 | 11,859 | 0.83 | 1.08 | 0.428 |
| mi-c7g | 5 | c7g (Graviton3) | 11,765 | 10,828 | 0.81 | 0.73 | 0.302 |
| mi-c8i | 5 | c8i (Granite Rapids) | 16,722 | 16,345 | 1.15 | 1.20 | 0.391 |
| mi-c8a | 5 | c8a (EPYC Turin) | 17,538 | 16,032 | 1.20 | 1.61 | 0.450 |
| mi-c8g | 5 | c8g (Graviton4) | 14,966 | 13,906 | 1.03 | 0.91 | 0.332 |
※1 hotspot 11 ケースそれぞれの正規化値の幾何平均 (各ケース等重み。実サービスにおける呼び出し頻度等による重み付けではありません)。 ※2 Compute Savings Plans (1年・全額前払) 適用後の 8vCPU/16GB スロット単価 (付録参照)。
注目すべきは最悪ケース (min) の差です。Fargate amd64 は min が mean の 75% まで落ちます (ガチャで c5 を引いた場合)。一方 MI は世代が固定されるので min ≈ mean で安定しています。「平均でどれだけ速いか」だけでなく「最低保証性能」を求めるなら MI が有利です。
処理内容別の分析 (どの CPU がどの処理に強いか)
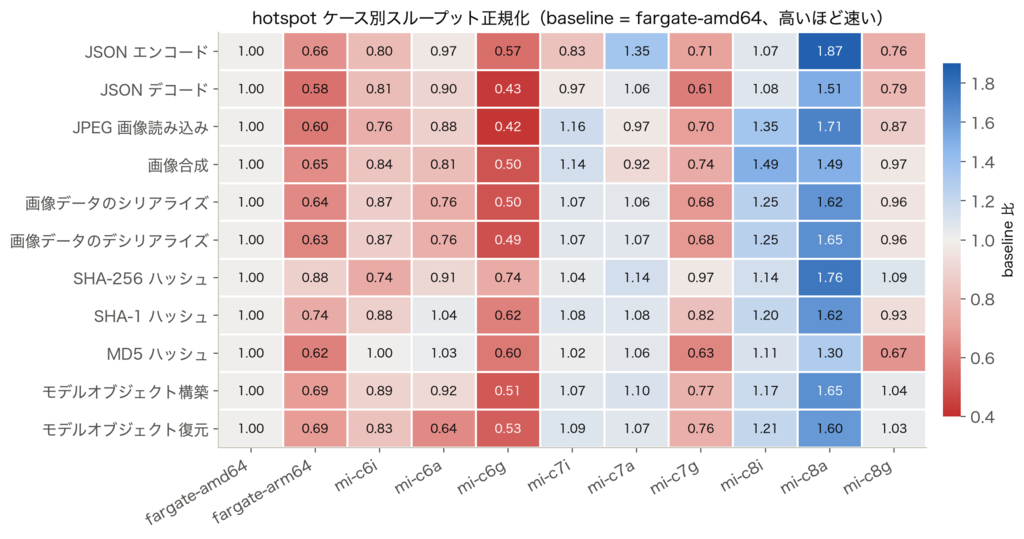
- c8a (EPYC Turin) が全ケースで最強です。特に JSON エンコード 1.87 / SHA-256 ハッシュ 1.76 / JPEG 画像読み込み 1.71 と、対象サービスのホットスポットである JSON・画像・ハッシュ処理すべてで突出しています
- c8i (Granite Rapids) は画像系に強く (画像合成 1.49、JPEG 画像読み込み 1.35)、JSON 系は 1.07〜1.08 と伸びが控えめです
- c7a (EPYC Genoa) は DKbench Overall では 0.83 と見劣りしますが、JSON エンコード 1.35 などアプリ実処理の幾何平均では 1.08 と悪くありません。汎用ベンチとアプリ実処理で評価が逆転する例です
- Graviton は今回の Perl アプリ実処理に弱いという結果でした。c7g は JSON デコード 0.61 / MD5 ハッシュ 0.63、Fargate arm64 では幾何平均 0.67 です。c8g でモデルオブジェクト構築や SHA-256 ハッシュなどは 1.0 を超えるまで改善しましたが、JSON・画像系は 0.76〜0.97 にとどまります
- c6g (Graviton2) は全 run 中で最も遅く (幾何平均 0.53、JPEG 画像読み込み 0.42 / JSON デコード 0.43)、Fargate arm64 の 0.5 vCPU 以下はこれに 100% 当たります (CPU ガチャの節参照)
- この弱点は DKbench の正規化スコア (c8g 1.03) だけを見ていても分かりませんでした。アーキテクチャ選定にはアプリ実処理のベンチマークが必須だと痛感した点です
コストパフォーマンス
性能 (score) ÷ スロット単価 ($/h) を baseline 比で比較しました。
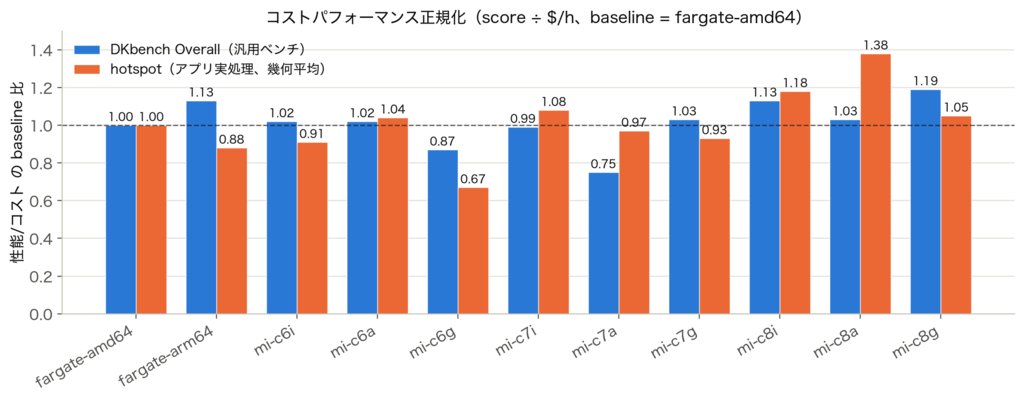
- DKbench Overall 基準: c8g 1.19 > fargate-arm64 1.13 ≈ c8i 1.13 の順で、Graviton・ARM の単価の安さが効きます (ただし c6g は 0.87 と例外的に低い)
- アプリ実処理 (
hotspot) 基準: c8a 1.38 > c8i 1.18 > c7i 1.08 > c8g 1.05 ≈ c6a 1.04 で、それ以外は baseline 以下です。Graviton は性能低下が単価差を食い潰し、c8g は 1.05 と辛うじて上回る程度、fargate-arm64 0.88 / c6g 0.67 と逆に不利になります
つまり、汎用ベンチだけを見て ARM に寄せると、今回のようなワークロードではコスト改善にならない可能性が高いということです。アプリ実処理基準では c8a、次点 c8i がコストパフォーマンス最良でした。
ベンチマークの取り方の工夫・難しさ
hotspot を作った理由
汎用ベンチマークの結果だけでは「対象サービスの実際の処理がどれだけ速くなるか」に答えられないため、当初からサービスの実処理を使った比較が必要だと考えていました。実際、前述の通り DKbench では c8g は 1.03 と baseline 超えでしたが、アプリ実処理では 0.91 と baseline 割れでした。この乖離は Graviton 系で特に大きく、汎用ベンチだけで ARM 移行を決めていたら期待したコスト削減は得られなかったはずです。
そこで、アプリの実コード (内部モジュール) を呼び出して実際のホットスポット 11 ケース (JSON エンコード/デコード、JPEG 画像読み込み、画像合成、画像データのシリアライズ/デシリアライズ、SHA-256/SHA-1/MD5 ハッシュ、モデルオブジェクトの構築/復元) を計測する自作マイクロベンチ hotspot を用意しました。
作成したベンチマーク基盤
多数の構成 × 多数のタスクを並列に計測して集計する必要があるため、次のような使い捨てのベンチマーク基盤を作りました。インフラ (ECR / S3 / ECS クラスタ / capacity provider / IAM) は検証用 AWS アカウント上に、1枚の Terraform ファイルで管理しています。
- イメージ: アプリケーションイメージをベースに、DKbench と
hotspotを追加したベンチ専用イメージをビルドして ECR に push します (amd64 / arm64 の 2 種) - 起動: 起動スクリプトで Fargate または MI のタスクを、指定した実行方法・タスクサイズ・台数で一括起動します
- 計測とアップロード: 各タスクは entrypoint でハードウェア情報 (ECS タスクメタデータ +
/proc/cpuinfo) を収集し、DKbench →hotspotを実行して、結果ファイルを結果保存用の S3 バケット (<run-id>/<task-id>/プレフィックス) にアップロードして終了します - 集計: 手元で集計 CLI (Python 製) が S3 から結果を sync し、CPU 世代判定・統計集計・正規化・コスト計算を行って Markdown やスプレッドシート形式のレポートを出力します
工夫した点は次のとおりです。
- 結果を S3 に集める方式にしたこと。たくさんのベンチを並列で回したいので、各 ECS タスクが自分の結果を S3 にアップロードし、手元でまとめて集計する疎結合な構成にしました。タスク同士の調整が不要になり、100 タスクの一括起動も気軽にできます
- MI では各インスタンスファミリー用の capacity provider をあらかじめ作っておくこと。MI は capacity provider の
allowedInstanceTypesでインスタンスファミリーを絞れるため、ファミリーごとに capacity provider を用意しておくと「CPU 世代を確定指定した run」が実現できます。Fargate と違い、世代を固定してベンチが取れるのが MI の計測上の利点でした - 起動時に実行方法やタスクサイズを指定できるようにしたこと。同じイメージ・同じスクリプトのまま「Fargate amd64 の 0.25 vCPU を 100 台」「MI c8a の 8 vCPU を 5 台」のように振り分けられるので、CPU ガチャのサイズ別スイープのような追加調査もすぐに実施できました
補足: スケールアウト起動時間の比較
CPU 性能とは別の軸として、「スパイク時にどれだけ速くタスクを並べられるか」も基盤選定の関心事です。そこで ECS サービスの desiredCount を 0→50 に一斉変更する純コールドなスケールアウトの起動時間を、Fargate (amd64 / arm64) と MI (c8a / c8i / c8g) の 5 バリアント × 各 3 run で計測しました (8vCPU タスク、実サイズ相当の約 500 MiB (圧縮) のイメージを使用)。
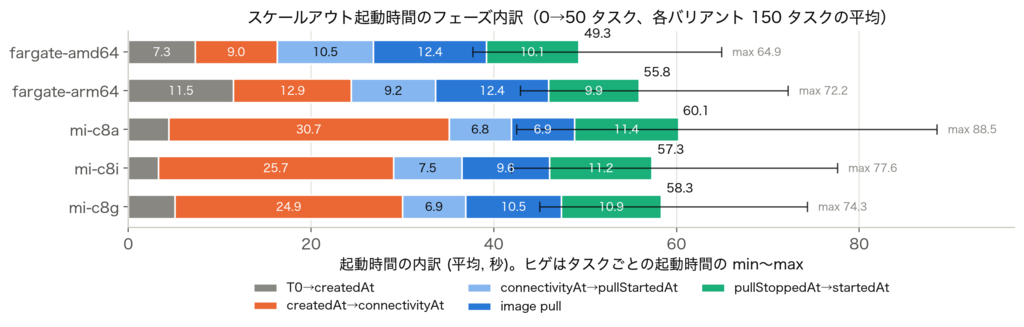
図中の各フェーズの意味は次のとおりです。
- T0→createdAt:
update-serviceの呼び出しからタスクが作成される (PENDINGになる) まで。起動要求の受理とタスクの配置に相当します - createdAt→connectivityAt: タスクのネットワーク接続性が確立する (
CONNECTEDになる) まで。Fargate では実行環境の確保、MI では EC2 インスタンスの起動〜ECS agent の登録に相当します - connectivityAt→pullStartedAt: 接続確立から image pull が始まるまでの準備
- image pull (pullStartedAt→pullStoppedAt): コンテナイメージの取得
- pullStoppedAt→startedAt: pull 完了からコンテナが起動し、タスクが
RUNNINGになるまで
計測結果のポイントは以下です。
- 中央値ではほぼ互角でした。起動時間の p50 は 47〜59 秒で、どのバリアントも「約 1 分で 50 台」が並びます。「MI は EC2 インスタンスを起動するから遅いはず」という事前予想は、中央値ベースでは外れました
- テール (遅いタスク) は MI が重い結果でした。50 台目が RUNNING になるまでの時間は Fargate 61.5〜72.2 秒に対し MI 66.9〜88.5 秒で、特に c8a が最長でした
- フェーズ内訳 (上図) を見ると構造の違いが分かります。MI は EC2 インスタンス起動〜ECS agent 接続 (createdAt→connectivityAt、平均 25〜31 秒) が全体の 4〜5 割を占め、ここがばらつきの源です。一方 Fargate は全フェーズが 7〜13 秒に分散して安定しており、「最後の 1 台まで揃う時間」の予測しやすさでは Fargate が優位です
- image pull は MI のほうが速いという結果でした (平均 6.9〜10.5 秒 vs Fargate 12.4 秒)。今回の MI は 1 インスタンス = 1 タスク固定でイメージキャッシュの共有を排除した最悪ケースの設計なので、複数タスクを同居させる実運用ではさらに短縮の余地があります
なお単日・同一時間帯の計測 (各バリアント 3 run) であること、タスクメモリが Fargate 16 GB / MI 14 GB と完全同一条件ではないことには注意してください。いずれにせよ差は中央値で十数秒・テールで 20 秒前後でした。この差をどう重み付けるかはワークロードのスパイク特性や運用要件次第ですが、少なくとも今回の計測では、前述の性能・コスト比較の結論を覆すほどの差は見られませんでした。
どういうパターンでどの構成を選択すると良いか
ここからは、今回の計測結果を選定の観点で整理します。あくまで「CPU バウンドな Perl 処理」を前提とした整理である点にご注意ください。
コストパフォーマンスの良い構成
- 第一候補: MI c8a。アプリ実処理コストパフォーマンス 1.38 で頭一つ抜けています。ただし東京リージョンでの提供開始 (2026年3月)から日が浅く、スケールアウト計測でも 50 台目の到達時間が全バリアント中最長でした。capacity provider の weight 設定などで c8i へのフォールバックを用意しておくと安心です
- 安定択: MI c8i。コストパフォーマンス 1.18、性能 1.15〜1.20 倍で、Intel なので互換性の懸念も最小です
- Graviton (c8g) は DKbench 基準ではコストパフォーマンス最良 (1.19) ですが、今回のアプリ実処理では 1.05 と c8i (1.18) に届きませんでした。ARM ビルド・運用の手間を払ってまで選ぶ理由は、このワークロードに関しては薄いと判断しています
Fargate はどういう時に選ぶべきか
- 向いているケース: インスタンス管理を一切持ちたくない小規模ワークロード、台数が少なく自前 EC2 との損益分岐 (後述) に届かない場合、スケールアウトの揃い時間 (テールまで) の予測可能性を重視する場合 (前節のとおり、中央値の速さ自体はほぼ互角でした)
- 不利な点: CPU ガチャにより性能が制御できず (同一 run 内で min が mean の 75%)、キャパシティプランニングは最悪ケース基準になります。またスロット単価 (amd64 0.385 $/h) は MI c8i (0.391 $/h) とほぼ同じなのに対し、性能あたりの実効単価では c8i (0.391 / 1.15 ≈ 0.34 $/h 相当) に大きく負けます
- 特に 0.5 vCPU 以下のタスクは最旧世代しか引けない (amd64 は 1 vCPU でも 71% が c5) ため、CPU バウンドな処理を小さいタスクで回す構成は避けるのが良さそうです
自前 EC2 と ECS Managed Instances の損益分岐点
MI は EC2 と同一ハードウェアで、EC2 On-Demand 料金の 12% が管理料金として上乗せされます。自前 EC2 はこの 12% がない代わりに、パッチ適用・AMI 更新・スケーリング調整などの運用工数 (ここでは 月 $1,000 と仮置き) が固定でかかります。損益分岐台数 N* は次の式で求められます。
N* = 運用工数 / ((MI 単価 − EC2 単価) × 730h)
自前 EC2 も MI・Fargate と同じ Compute Savings Plans (1年・全額前払) で支払う前提です。このとき MI と EC2 の単価差はちょうど「On-Demand × 管理料 12%」になります。
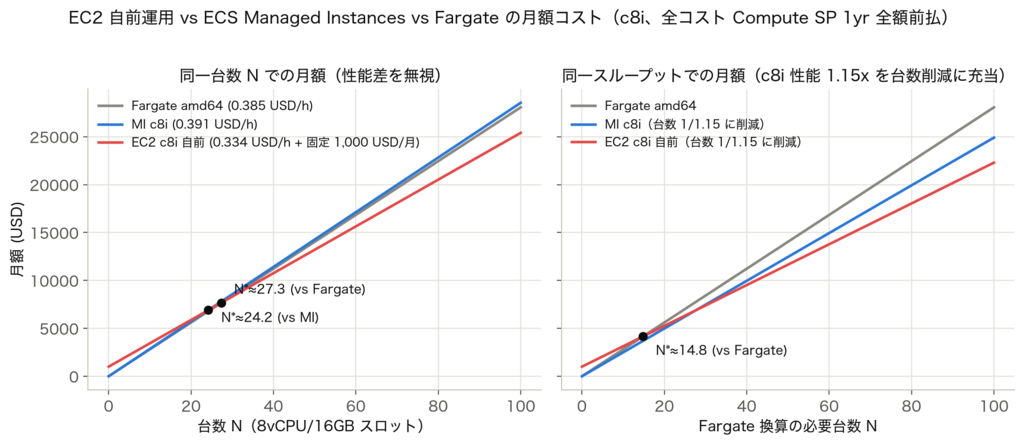
- 同一台数比較 (左図): c8i では N≈24.2、つまり 25 台以上を常時運用するなら自前 EC2 が MI より安くなります。Fargate 比でも N≈27.3 です。運用するタスク数が多いほど、固定の運用工数が薄まり自前 EC2 が有利になります
- 性能差込み比較 (右図): Fargate (世代混在、性能 1.00) を c8i (1.15 倍) に置き換えると必要台数が 1/1.15 になるため、Fargate 換算 N*≈15 台で自前 EC2 が Fargate を下回ります。また MI c8i は実効単価 0.391 / 1.15 ≈ 0.34 $/h となり、台数によらず Fargate amd64 (0.385 $/h) より約 11% 安くなります
ファミリー別の N* (vs MI、8vCPU/16GB スロット換算、Compute SP 1yr 全額前払) は次のとおりです。
| ファミリー | MI $/h | EC2 $/h | N* |
|---|---|---|---|
| c6i | 0.3546 | 0.3033 | 27 |
| c7i | 0.3723 | 0.3184 | 26 |
| c8i | 0.3910 | 0.3343 | 25 |
| c6a | 0.3192 | 0.2729 | 30 |
| c7a | 0.4282 | 0.3662 | 23 |
| c8a | 0.4496 | 0.3845 | 22 |
| c6g | 0.3049 | 0.2638 | 34 |
| c7g | 0.3015 | 0.2578 | 32 |
| c8g | 0.3316 | 0.2836 | 29 |
N は運用工数の仮定に線形に比例する点に注意してください (月 $2,000 相当なら N は倍になります)。逆に既に EC2 運用のノウハウや自動化があり増分工数が小さいなら、より少ない台数でも自前が有利になります。
選択の指針まとめ
| パターン | 推奨構成 |
|---|---|
| 常時数十台規模以上・運用体制あり | 自前 EC2 (c8i / c8a) + Compute SP (インスタンスファミリー固定を許容できるなら EC2 Instance SP でさらに安く) |
| 中規模・運用レスにしたい | MI c8a (c8i フォールバック付き) + Compute SP |
| 小規模・スパイク型・管理ゼロ | Fargate (ただし 2 vCPU 以上のタスクサイズにする) |
| ARM 移行 | 今回のワークロードでは非推奨 (アプリ実処理でコストパフォーマンス優位なし。c9g 世代で再評価) |
まとめ
今回のベンチマークで得た知見をまとめます。
Fargate の CPU ガチャはタスクサイズに強く依存する
Fargate はタスクサイズによって引ける CPU 世代の範囲そのものが違います (曜日や時間帯等によって異なるかもしれません)。CPU バウンドな処理を Fargate で運用するなら、タスクサイズや CPU 世代の出現傾向、最悪ケースを織り込んだキャパシティプランニングが必要です。
汎用ベンチとアプリ実処理でコストパフォーマンスの評価は逆転し得る
DKbench 基準では Graviton (c8g) が最良、アプリ実処理基準では c8a / c8i が最良と、指標によって結論が入れ替わりました。アーキテクチャ選定を汎用ベンチだけで判断するのは危険で、アプリの実コードを使ったベンチマークを持っておくことを強くお勧めします。
ECS Managed Instances で「世代固定 × 運用レス」の中間択が生まれた
これまで「性能を固定したいなら EC2 自前、運用レスにしたいなら Fargate (ただし世代は運任せ)」の二択だったところに、MI という「CPU 世代を固定しつつインスタンス管理は AWS に任せる」選択肢が加わりました。管理料 12% と運用工数のトレードオフは損益分岐台数である程度定量的に判断できます。
付録
使用したベンチマークツール
DKbench (Benchmark::DKbench v3.02)
- Perl 向けの汎用 CPU ベンチマークスイート (Astro 計算、BioPerl、行列、正規表現、暗号化など約 20 種)。CPAN からバージョン固定でインストールしました
- シングルコア性能を見るためシングルスレッド (
--no_mce)・5 iteration で実行しています - OpenSSL 3.x が 512bit RSA 鍵を拒否するため、同梱テスト鍵を実行時生成の 2048bit 鍵に差し替えるパッチをイメージビルド時に適用しています
hotspot (自作)
- 対象サービスの実コード (内部モジュール) を使った自作マイクロベンチで、実際のホットスポットに対応する 11 ケースを計測します
- 画像 / JSON 系: JSON エンコード / JSON デコード / JPEG 画像読み込み / 画像合成 / 画像データのシリアライズ / 画像データのデシリアライズ
- バックエンド系: SHA-256 / SHA-1 / MD5 ハッシュ / モデルオブジェクト構築 / モデルオブジェクト復元
- warmup 3 回 → 1 バッチ ≈ 1000ms になるよう回数を自動調整 → 15 回計測し、ops/sec を算出します (高いほど速い)
EC2 RI, EC2 Instance Savings Plans, Compute Savings Plans の違い
コスト比較の前提とした割引オプションの違いを整理しておきます。
| EC2 Reserved Instances (RI) | EC2 Instance Savings Plans | Compute Savings Plans | |
|---|---|---|---|
| コミット対象 | 特定のインスタンス構成 (ファミリー × リージョン、Standard/Convertible) | リージョン × インスタンスファミリーへの $/h コミット | $/h コミットのみ |
| 柔軟性 | 低い (Standard は変更不可、Convertible は交換手続きが必要) | ファミリー内ならサイズ・OS・テナンシー自由 | EC2 全ファミリー・全リージョンに加え Fargate / Lambda にも適用 |
| 割引率 (1年全額前払、ap-northeast-1) | Standard は Instance SP とほぼ同水準 (Convertible は Compute SP 相当) | 高い (38% 引き) | 低い (EC2 c 系 29% 引き。Fargate x86 は 22%、ARM は 26.5%、c6g は 23% と対象によりさらに低い) |
| キャパシティ予約 | Zonal RI のみ可能 | なし (ODCR の併用で確保可能) | なし (ODCR の併用で確保可能) |
| 使いどころ | 割引は Instance SP、キャパシティ確保は ODCR 併用でほぼ代替できるため、新規で選ぶ場面は少ない | ファミリー・リージョンを固定できる安定したワークロードで割引を最大化したい場合 | ファミリーやリージョンの変更余地を残したい場合、Fargate / Lambda も対象に含めたい場合 |
- 本記事は全構成を Compute Savings Plans (1年・全額前払) で統一しています。Fargate に適用できるのが Compute SP のみのため、比較条件を揃える目的です
- キャパシティの確保が必要な場合は EC2 On-Demand Capacity Reservations (ODCR) を併用できます。ODCR で確保したインスタンスの使用分にも Savings Plans は適用されます
- ファミリーを固定できるなら、MI・自前 EC2 の EC2 使用分は EC2 Instance SP (38% 引き) に切り替えることで Compute SP よりさらに約 13% 安くなります。「c8i から c8a に乗り換えるかもしれない」といった世代・ファミリーの流動性を残したい場合は Compute SP が向きます
- RI は割引水準が Instance SP とほぼ同じ (Standard の場合) で柔軟性が低いため、今回は選択肢として考慮しませんでした
使用した AWS の料金データ
料金は AWS Price List (AWSComputeSavingsPlan / AmazonEC2) から取得した ap-northeast-1 の実レート (publication 2026-06-30) を使用しています。主な値は次のとおりです。
| パラメータ | 値 | 意味 |
|---|---|---|
| Fargate amd64 (Compute SP) | 0.039437 $/vCPU/h + 0.004313 $/GB/h | Compute SP 1yr 全額前払 単価 |
| Fargate arm64 (Compute SP) | 0.02973 $/vCPU/h + 0.00325 $/GB/h | 同上 (ARM) |
| MI 各ファミリー | 0.34〜0.54 $/h | *.2xlarge (8vCPU/16GB) On-Demand 単価。管理料算定用 |
| MI / EC2 各ファミリー (Compute SP) | 0.26〜0.38 $/h | 同インスタンスの Compute SP 1yr 全額前払 単価。MI・自前 EC2 共通 |
| MI 管理料率 | 12% | On-Demand 単価基準 (SP 適用後も On-Demand 基準で算定) |
| 運用工数 | 1,000 $/月 | 自前 EC2 運用の固定工数 (仮置き) |
コスト比較は全構成を 8vCPU/16GB スロットに統一して算出しています。

